How to Prepare a Dataset for Fine-Tuning a Language Model
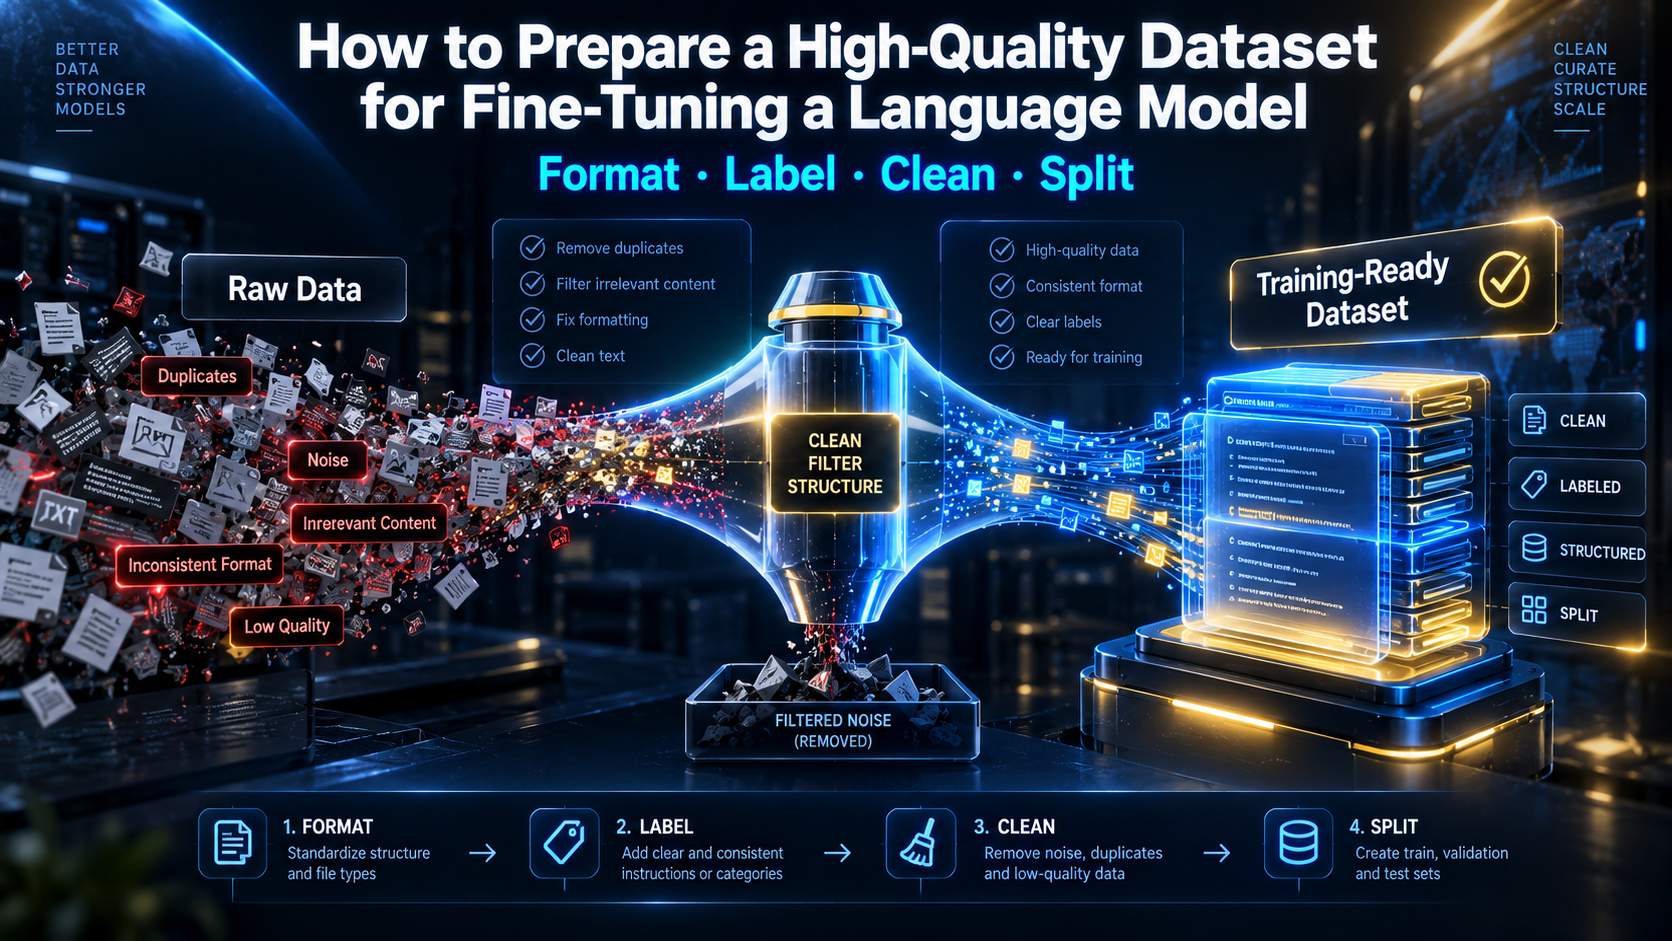
Most fine-tuning failures happen before training starts. Bad labels, missing EOS tokens, contaminated test sets — these are data bugs that show up as model bugs. This guide covers every stage of dataset preparation: format selection, cleaning, deduplication, labeling quality, splitting, and tokenization. With the research behind every claim.